Jev: Das KI-Modell, das Entscheidungen trifft, statt Text zu schreiben
Am 15. September 2026 kam TypeSafe AI mit einem Modell ganz anderer Art aus der Stealth-Phase hervor. Das Unternehmen, gegründet von Diogo Almeida (dem OpenAI-Forscher hinter RLHF und InstructGPT), Erik Gafni und Sasha Sheng, sammelte eine 40-Millionen-Dollar-Seed-Runde unter Führung von DCVC ein. Das erste Produkt ist Jev — ein KI-Modell, das überhaupt keinen Text generiert. Stattdessen trifft es Entscheidungen.
Jev ist das erste von TypeSafes System One Models. Während klassische LLM-APIs nach dem Muster Input → Modell → generierter Text funktionieren, arbeitet Jev nach dem Prinzip Input → Modell → typisierte Entscheidung. Du gibst dem Modell Anwendungszustand und eine konkrete Frage, und es liefert eine Auswahl, eine Bewertung, eine Wahrscheinlichkeit und einen Konfidenzwert zurück — etwas, auf das dein Code direkt verzweigen kann.
Entscheidungen statt Absätze
Du fragst Jev: Ist diese Transaktion verdächtig? In welche Support-Queue soll dieses Ticket? Welches Tool soll der Agent als Nächstes aufrufen?
Statt eines Absatzes, den deine Anwendung erst parsen muss, liefert Jev eine strukturierte Antwort. Wenn es fünf mögliche Kategorien gibt, wählt es genau eine davon — es kann sich keine beliebige sechste Antwort ausdenken. Wenn es ein Dokument bewerten soll, liefert es eine Zahl auf einer vordefinierten Skala, samt Wahrscheinlichkeiten pro Stufe.
Die gesamte API besteht aus drei Fragetypen — das ist Design, keine Limitierung:
- Choice — wähle eine Option aus einer von dir definierten Menge (bis zu 255), mit kompletter Wahrscheinlichkeitsverteilung und Konfidenz.
- Score — bewerte den Zustand auf einer geordneten Skala von 2–10 Stufen, zurückgegeben als wahrscheinlichkeitsgewichtete Position.
- Ja/Nein — eine simple boolesche Beurteilung mit Konfidenz.
Mehrere Fragen lassen sich in einem einzigen parallelen Durchlauf beantworten, und jede Antwort kommt mit einem kalibrierten Konfidenzwert. TypeSafe hat Jev mit einer Methode namens RLCD (Reinforcement Learning for Calibrated Decisions) trainiert, die sicherstellt, dass die angegebene Konfidenz dem tatsächlichen Anteil richtiger Antworten entspricht. Genau das macht automatisierte Workflows sicher: Entscheidungen mit hoher Konfidenz können autonom ablaufen, unsichere werden an einen Menschen oder ein leistungsfähigeres Modell weitergereicht.
Warum das nützlich ist
Das stärkste Argument ist Geschwindigkeit und Kosten. TypeSafe nennt eine End-to-End-Latenz von 70–500ms und verlangt für Jev 0,042 US-Dollar pro Million Input-Tokens (die Ausgabe ist kostenlos — das Modell gibt nie Prosa aus). Das Unternehmen behauptet, bei den kleinen, repetitiven Entscheidungen, für die Jev gedacht ist, bis zu 100–200× schneller und 40–445× günstiger zu sein als generative Frontier-Modelle. Jev verarbeitet zudem einen Kontext von 64k Tokens und ist über Early Access, OpenRouter und die gängigen AI-Gateways verfügbar.
Das macht eine bestimmte Architektur attraktiv — besonders für KI-Agenten. Ein Agent trifft ständig kleine Entscheidungen: Welches Tool soll ich nutzen? Soll ich es erneut versuchen? Ist diese Aktion sicher? Braucht das eine menschliche Freigabe? Für jeden dieser Aufrufe ein Frontier-LLM zu bezahlen, ist langsam und teuer. Jev kann unter dem Agenten sitzen und die günstigen, häufigen Beurteilungen übernehmen, während ein GPT- oder Claude-artiges Modell für die Teile reserviert bleibt, die tatsächlich Reasoning oder Textgenerierung erfordern:
Jev für Entscheidungen → normaler Code für deterministische Logik → Frontier-LLM für Generierung und komplexes Reasoning.
Die Schwächen
Jev ist kein Ersatz für ChatGPT oder Claude. Es kann keine Artikel schreiben, keinen Code generieren, keine Gespräche führen oder lange Erklärungen liefern. Es ist für begrenzte Entscheidungen gebaut, und TypeSafe dokumentiert Schwächen offen bei Arithmetik, Zählen, Datumsvergleichen, mehrdeutigen Anweisungen und zu großem oder verrauschtem Kontext. Für Berechnungen und deterministische Regeln bleibt konventioneller Code das richtige Werkzeug.
Außerdem gibt es eine wichtige Feinheit beim Thema Halluzinationen. Jevs begrenzte Ausgabe eliminiert einige Formen davon — es kann keine Option erfinden, die nie erlaubt war. Das heißt aber nicht, dass es nicht falsch liegen kann. Es kann immer noch die falsche Antwort wählen — und das mit hoher Konfidenz. Die Kalibrierung verrät dir, wann du ihm vertrauen kannst, sie macht das Urteil aber nicht richtig.
Die Community hat außerdem quelloffene Neuimplementierungen des Interfaces veröffentlicht (etwa openjev und jevlike, basierend auf offenen Modellen). Das sind nicht Jev — das Modell selbst ist eine geschlossene, verwaltete API ohne offene Gewichte — aber sie zeigen, dass das Interface simpel genug ist, um es nachzubauen.
Das Fazit
Keine dieser Einzelideen ist neu. Klassifikation und probabilistische Vorhersage gibt es seit Jahrzehnten. Interessant an Jev ist, dass TypeSafe moderne KI in eine Software-Primitive verwandeln will. Statt ein Modell eine Antwort schreiben zu lassen und diese Antwort dann zu Daten zurückzuparsen, startet Jev mit Daten und gibt eine Entscheidung zurück.
Die Zukunft ist vielleicht nicht ein einzelnes Riesenmodell, das alles kann. Vielleicht ist es ein Stack, in dem verschiedene Modelle unterschiedliche Jobs übernehmen — mit Jev als schneller, günstiger Entscheidungsebene, sodass der Rest deiner Anwendung nur ein Boolean prüfen und weitermachen muss.
Nächste Artikel.
Atomic Arch. Wie 1.500 AUR-Pakete ohne Exploit gekapert wurden
Analyse der jüngsten Atomic-Arch-Supply-Chain-Kampagne. Angreifer übernahmen verwaiste Arch-Linux-Pakete, um einen Credential-Stealer und ein eBPF-Rootkit zu verbreiten. Was Sie über den Vorfall wissen müssen.
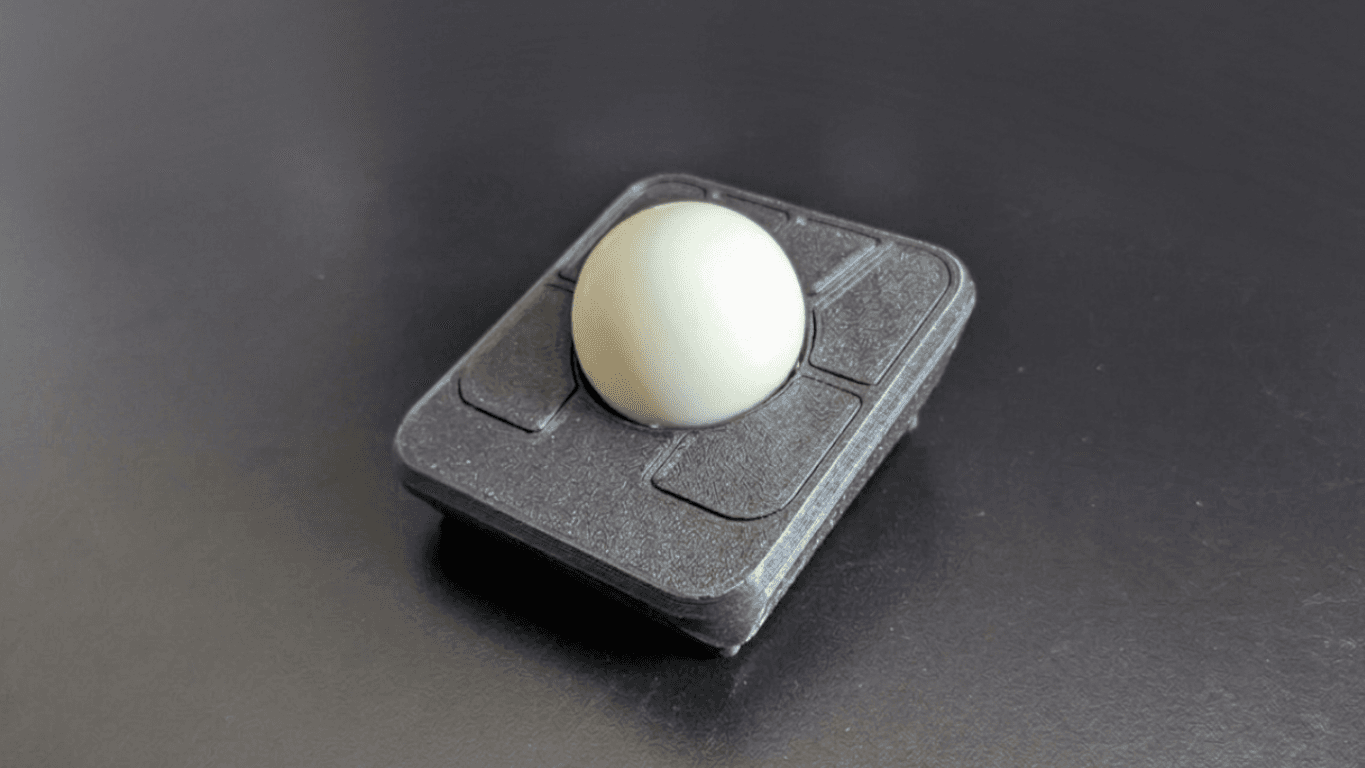
Bau des Ploopy Adept BLE (Any Ball Mod)
Ein umfassender Guide zum Bau eines kabellosen Ploopy Adept Trackballs mit dem Any Ball Mod, der PCB-Bestellung und der Montage der Komponenten.
C# String-Bugs vermeiden: CultureInfo, ToUpper und das 'Türkische I'
Du denkst, .ToUpper() ist sicher? Weit gefehlt. Wir werfen einen Blick auf CultureInfo, den 'Turkish I'-Bug und warum einfache String-Operationen deine Production-App im Ausland crashen lassen.